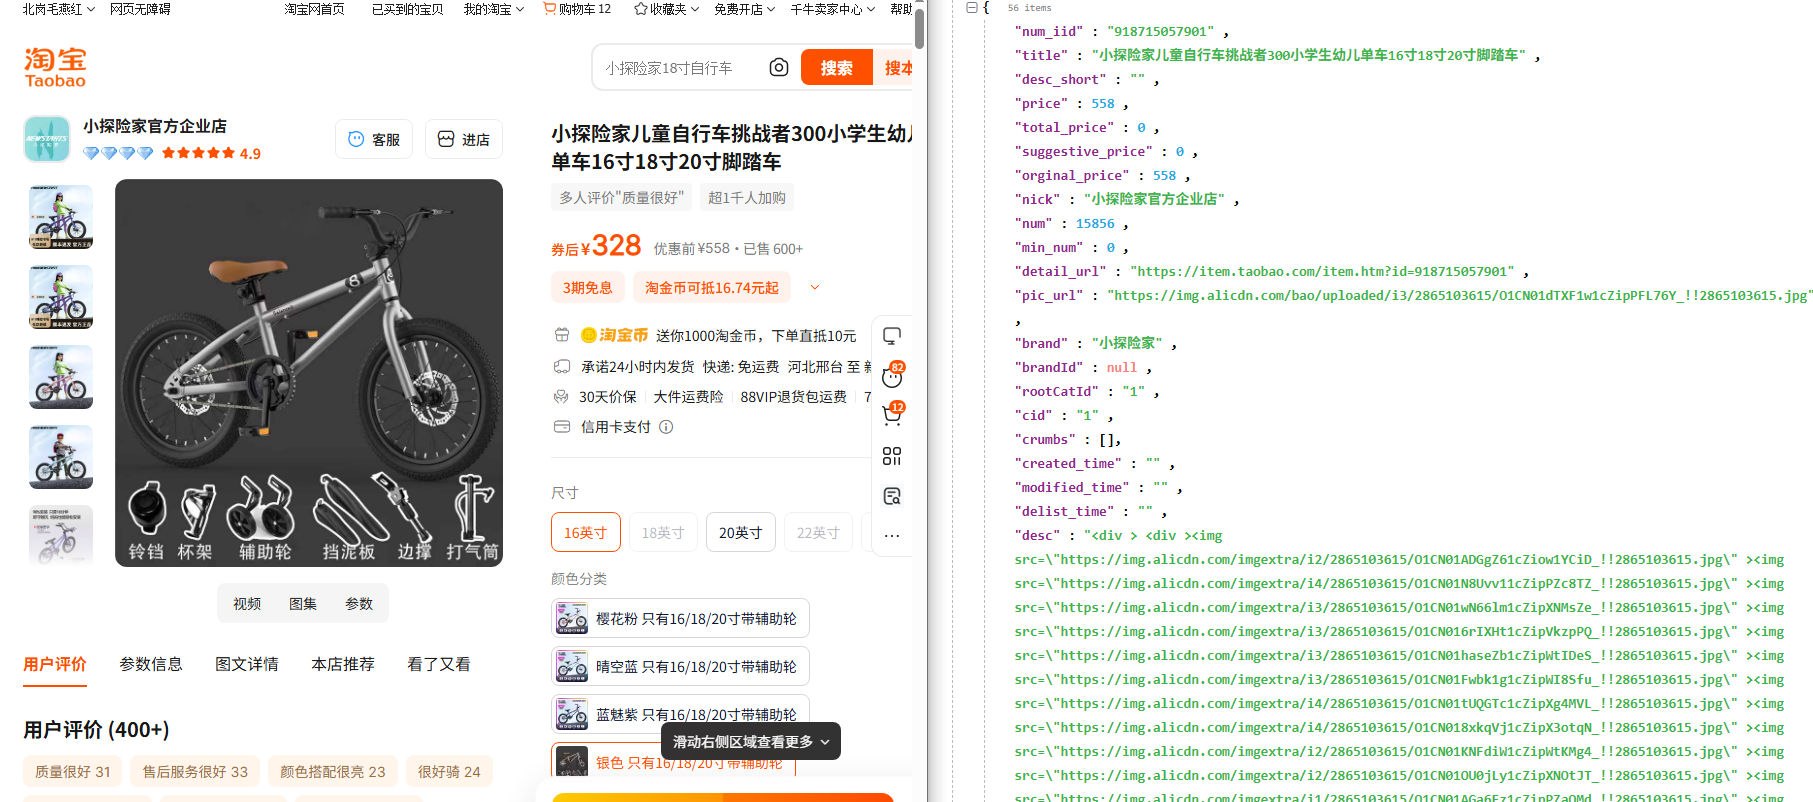
淘宝商品评论接口完全指南:字段、对接、计费与选型避坑
面向人群:做电商数据分析、选品工具、舆情监控、AI 语料建设的开发者与产品负责人。
读完你能搞清楚:淘宝评论数据怎么拿、接口能返回哪些字段、成本怎么算、以及哪些坑要提前避开。
一、为什么这么多业务都在调淘宝评论数据
商品评论是电商平台里"离成交决策最近"的一层数据。实际项目里,我们见到调用量最大的几类场景:
| 场景 | 典型用法 |
|---|---|
| 选品与铺货 | 批量拉取候选商品的评论,判断差评点、退货原因,辅助选品决策 |
| 竞品分析 | 监控竞品评论增速与差评关键词,反推对方的品控变化 |
| 舆情与品牌监控 | 追踪自家品牌在淘宝侧的评价趋势,及时发现批次性质量问题 |
| 反向海淘 / 代采 | 海外买家下单前看不到评价体系,需要结构化评论翻译后展示 |
| AI 语料建设 | 情感分析、评论摘要、客服话术训练,都需要大规模真实评论文本 |
这些场景的共同点是:需要的是持续、稳定、结构化的数据流,而不是一次性爬几页下来。这也是大多数人最后选择对接评论接口而不是自建采集的原因。
二、淘宝商品评论接口能拿到什么
以市面上成熟的淘宝评论接口为例,一次调用通常可以返回:
评论文本:主评内容、追评内容
评分信息:星级、描述相符 / 物流服务 / 服务态度三项子分
买家维度:会员等级、购买SKU(颜色、尺码等规格)
时间维度:评论时间、追评时间
媒体信息:晒图 URL、视频封面
有用性数据:点赞数、评论总数
需要注意两点:
不同服务商标注的"评论接口"深度不一样,有的只给文本,有的连追评和晒图都能覆盖。对接前一定要先确认字段清单,最好让对方发一份真实返回样例,而不是只看文档宣传页。
评论数据有天然的"增量属性"——历史评论基本不变,新增评论按天产生。工程上要做增量拉取,而不是每次全量重跑,这直接决定你的调用成本。
三、对接流程与代码示例
主流接口都是 REST 风格,对接三步:申请 key → 拼参数调用 → 解析 JSON。以 Python 为例:
import requests
import time

API_URL = "https://api.your-provider.com/taobao/item_review"
PARAMS = {
    "key": "你的调用Key",
    "num_iid": "商品ID",        # 淘宝商品数字ID
    "page": 1,                  # 页码
    "sort": "default",          # 排序:default / rate_desc / rate_asc
}
resp = requests.get(API_URL, params=PARAMS, timeout=10)
data = resp.json()

for review in data.get("reviews", []):
    print(review["display_time"], review["content"][:40])
    print("  追评:", review.get("append_content", "无"))
返回结构通常长这样(截取核心字段):
{
"num_iid"
:
"679245830521"
,
"total_reviews"
:
4823
,
"reviews"
:
[
{
"rate_content"
:
"质量很好,第二次回购了,物流也快"
,
"rate_date"
:
"2026-09-15"
,
"display_user"
:
"t**7"
,
"sku_map"
:
"颜色:黑色;尺码:L"
,
"pic_urls"
:
[
"https://img.alicdn.com/xxx.jpg"
]
,
"append_content"
:
"用了一周,没有出现掉色"
,
"append_time"
:
"2026-09-20"
}
]
}
四、工程上必须处理好的三件事
1. 分页与全量抓取
评论列表通常按页返回(每页 10–20 条)。要拿一个 5000 条评论的商品全量数据,需要翻 250–500 页。接口方一般会对单商品翻页深度有限制,超出部分走特殊通道或加计费,商务谈判时把这个问清楚。
2. 增量拉取
用"上次拉取的最新评论时间"作为游标,只拉新增部分。一个每天新增 50 条评论的商品,每天一次调用就够了,成本比全量重跑低两个数量级。
3. 限频与重试
高峰时段(大促)评论量激增,接口方可能触发限频。客户端要做指数退避重试,并对失败的批次落盘,而不是丢弃——评论数据补抓的成本很高。
五、自建采集 vs 成熟接口:成本账怎么算
| 维度 | 自建爬虫 | 第三方评论接口 |
|---|---|---|
| 启动成本 | 需要维护代理池、账号池、验证码识别,2–3 人月起 | 当天可通,一个 key 就能跑 |
| 稳定性 | 淘宝反爬升级(滑块、风控)随时断流 | 服务方专职对抗风控,承诺可用率 |
| 单条成本 | 表面免费,算上服务器 + 代理 + 人力,量小反而更贵 | 按量几分钱/条,量大有阶梯价 |
| 合规风险 | 自行突破反爬有法律灰区 | 服务商负责数据边界的合规审查 |
| 适合谁 | 有技术团队、量极大、要求深度定制的团队 | 绝大多数业务方 |
一句话结论:日均调用量在几万次以下,自建几乎不划算。把精力放在数据的应用层(分析、模型、业务逻辑),数据获取交给专业服务,是更优的分工。
六、计费模式与成本估算
市面上评论接口基本是两种计费模式:
按量计费:单次调用单价几分钱,充值后按实际调用次数扣减,适合用量波动大的业务;
套餐包月:固定月费包固定日调用量,折算单价比按量低不少,适合日均量稳定的场景。
估算时记住一个公式:月成本 ≈ 日均调用次数 × 30 × 单价。
比如日均 1 万次、按量单价 0.02 元,月成本约 6000 元;如果套餐能把单价压到 0.01 元以下,月成本直接减半。所以日均量过千就该去谈阶梯价了,大部分服务商对大客户都有空间。
选服务商时重点核对四项:字段覆盖深度(尤其追评和晒图)、单商品翻页上限、限频阈值、计费是按"调用次数"还是按"返回条数"——最后这条是最常见的坑,差一个口径成本差十倍。
七、合规红线:这些事不能做
评论数据虽然公开可见,但拿来做下面的事是明确的高压线:
批量抓取并存储买家个人信息(昵称、头像、主页链接)用于营销或转售;
用评论数据刷单、刷好评、攻击竞品;
未经脱敏直接把原始评论文据用于对外商业化产品。
正规的服务商会在这几条上主动设卡,这也是判断一个数据服务商靠不靠谱的简单方法——对合规闭口不谈、什么数据都敢卖的,反而要小心。
八、常见问题
Q:能拉到商品的全部历史评论吗?
A:取决于服务商的翻页深度策略,主流可覆盖最近数千条,部分支持全量(需定制)。对接前让对方拿你的目标商品实测一遍最靠谱。
Q:大促期间评论量暴涨,接口顶得住吗?
A:正规服务商大促前会扩容并提前通知限频策略,自己这边做好队列缓冲即可。
Q:可以先测试再充值吗?
A:成熟的服务商都提供测试额度,拿真实目标商品跑通字段、覆盖率、延迟三项,再谈付费。
Q:除了评论,还能拿淘宝哪些数据?
A:同一套 key 体系下,商品详情、搜索列表、店铺信息、销量价格历史等一般都有对应接口,可以统一对接。
写在最后
淘宝评论数据的门槛从来不在"能不能拿到",而在拿得稳、拿得便宜、拿得合规。如果你正在做选品工具、竞品监控或反向海淘项目,评估阶段最重要的一件事就是:拿你的真实商品列表去实测服务商的返回质量,而不是看广告页。
有字段定制、批量测试额度方面的需求,欢迎留言或私信交流。